十二、Kubernetes学习笔记—Pod的调度
十二、Pod资源的调度
12.1 Pod资源的调度
API Server在接受客户端提交Pod对象创建请求后,然后是通过调度器(kube-schedule)从集群中选择一个可用的最佳节点来创建并运行Pod。而这一个创建Pod对象,在调度的过程当中有3个阶段:节点预选、节点优选、节点选定,从而筛选出最佳的节点。如图:
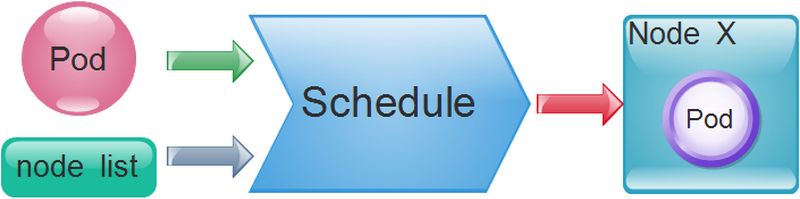
- 节点预选:基于一系列的预选规则对每个节点进行检查,将那些不符合条件的节点过滤,从而完成节点的预选
- 节点优选:对预选出的节点进行优先级排序,以便选出最合适运行Pod对象的节点
- 节点选定:从优先级排序结果中挑选出优先级最高的节点运行Pod,当这类节点多于1个时,则进行随机选择
当我们有需求要将某些Pod资源运行在特定的节点上时,我们可以通过组合节点标签,以及Pod标签或标签选择器来匹配特定的预选策略并完成调度,如MatchInterPodAfinity、MatchNodeSelector、PodToleratesNodeTaints等预选策略,这些策略常用于为用户提供自定义Pod亲和性或反亲和性、节点亲和性以及基于污点及容忍度的调度机制。
12.2 常用的预选策略
预选策略实际上就是节点过滤器,例如节点标签必须能够匹配到Pod资源的标签选择器(MatchNodeSelector实现的规则),以及Pod容器的资源请求量不能大于节点上剩余的可分配资源(PodFitsResource规则)等等。执行预选操作,调度器会逐一根据规则进行筛选,如果预选没能选定一个合适的节点,此时Pod会一直处于Pending状态,直到有一个可用节点完成调度。其常用的预选策略如下:
- CheckNodeCondition:检查是否可以在节点报告磁盘、网络不可用或未准备好的情况下将Pod对象调度其上。
- HostName:如果Pod对象拥有spec.hostname属性,则检查节点名称字符串是否和该属性值匹配。
- PodFitsHostPorts:如果Pod对象定义了ports.hostPort属性,则检查Pod指定的端口是否已经被节点上的其他容器或服务占用。
- MatchNodeSelector:如果Pod对象定义了spec.nodeSelector属性,则检查节点标签是否和该属性匹配。
- NoDiskConflict:检查Pod对象请求的存储卷在该节点上可用。
- PodFitsResources:检查节点上的资源(CPU、内存)可用性是否满足Pod对象的运行需求。
- PodToleratesNodeTaints:如果Pod对象中定义了spec.tolerations属性,则需要检查该属性值是否可以接纳节点定义的污点(taints)。
- PodToleratesNodeNoExecuteTaints:如果Pod对象定义了spec.tolerations属性,检查该属性是否接纳节点的NoExecute类型的污点。
- CheckNodeLabelPresence:仅检查节点上指定的所有标签的存在性,要检查的标签以及其可否存在取决于用户的定义。
- CheckServiceAffinity:根据当前Pod对象所属的Service已有其他Pod对象所运行的节点调度,目前是将相同的Service的Pod对象放在同一个或同一类节点上。
- MaxEBSVolumeCount:检查节点上是否已挂载EBS存储卷数量是否超过了设置的最大值,默认值:39
- MaxGCEPDVolumeCount:检查节点上已挂载的GCE PD存储卷是否超过了设置的最大值,默认值:16
- MaxAzureDiskVolumeCount:检查节点上已挂载的Azure Disk存储卷数量是否超过了设置的最大值,默认值:16
- CheckVolumeBinding:检查节点上已绑定和未绑定的PVC是否满足Pod对象的存储卷需求。
- NoVolumeZoneConflct:在给定了区域限制的前提下,检查在该节点上部署Pod对象是否存在存储卷冲突。
- CheckNodeMemoryPressure:在给定了节点已经上报了存在内存资源压力过大的状态,则需要检查该Pod是否可以调度到该节点上。
- CheckNodePIDPressure:如果给定的节点已经报告了存在PID资源压力过大的状态,则需要检查该Pod是否可以调度到该节点上。
- CheckNodeDiskPressure:如果给定的节点存在磁盘资源压力过大,则检查该Pod对象是否可以调度到该节点上。
- MatchInterPodAffinity:检查给定的节点能否可以满足Pod对象的亲和性和反亲和性条件,用来实现Pod亲和性调度或反亲和性调度。
在上面的这些预选策略里面,CheckNodeLabelPressure和CheckServiceAffinity可以在预选过程中结合用户自定义调度逻辑,这些策略叫做可配置策略。其他不接受参数进行自定义配置的称为静态策略。
12.3 优选函数
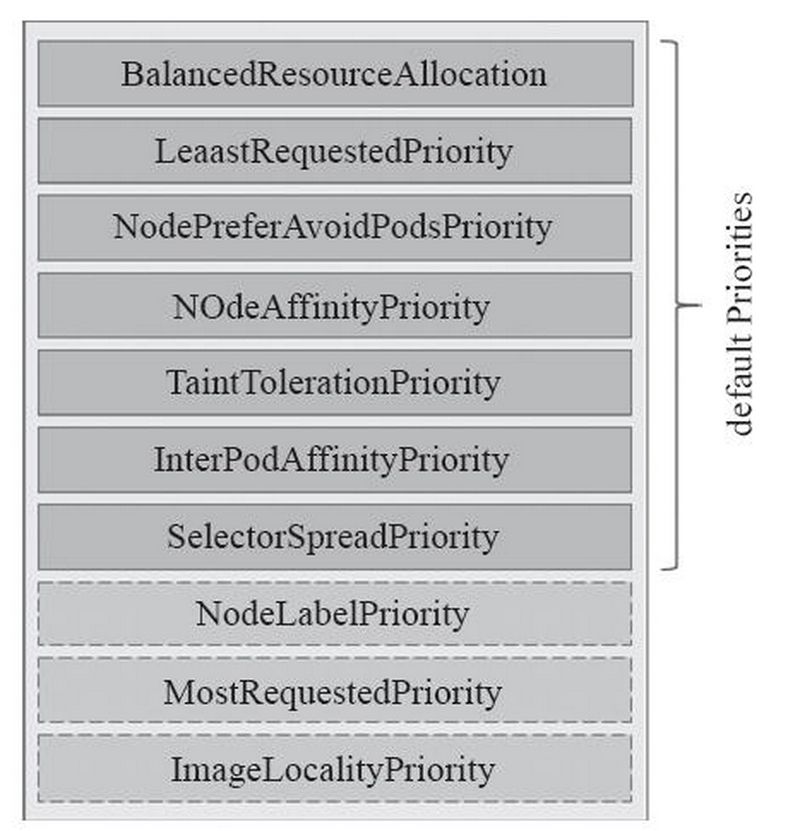
预选策略筛选出一个节点列表就会进入优选阶段,在这个过程调度器会向每个通过预选的节点传递一系列的优选函数来计算其优先级分值,优先级分值介于0-10之间,其中0表示不适用,10表示最适合托管该Pod对象。
另外,调度器还支持给每个优选函数指定一个简单的值,表示权重,进行节点优先级分值计算时,它首先将每个优选函数的计算得分乘以权重,然后再将所有优选函数的得分相加,从而得出节点的最终优先级分值。权重可以让管理员定义优选函数倾向性的能力,其计算优先级的得分公式如下:
1 | finalScoreNode = (weight1 * priorityFunc1) + (weight2 * priorityFunc2) + ...... |
下图是关于优选函数的列表图:
12.4 节点亲和调度
节点亲和性是用来确定Pod对象调度到哪一个节点的规则,这些规则基于节点上的自定义标签和Pod对象上指定的标签选择器进行定义。
定义节点亲和性规则有2种:硬亲和性(require)和软亲和性(preferred)
- 硬亲和性:实现的是强制性规则,是Pod调度时必须满足的规则,否则Pod对象的状态会一直是Pending
- 软亲和性:实现的是一种柔性调度限制,在Pod调度时可以尽量满足其规则,在无法满足规则时,可以调度到一个不匹配规则的节点之上。
定义节点亲和规则的两个要点:一是节点配置是否合乎需求的标签,而是Pod对象定义合理的标签选择器,这样才能够基于标签选择出期望的目标节点。
需要注意的是preferredDuringSchedulingIgnoredDuringExecution和requiredDuringSchedulingIgnoredDuringExecution名字中后半段字符串IgnoredDuringExecution表示的是,在Pod资源基于节点亲和性规则调度到某个节点之后,如果节点的标签发生了改变,调度器不会将Pod对象从该节点上移除,因为该规则仅对新建的Pod对象有效。
12.4.1 节点硬亲和性
节点亲和通过 Pod.Spec 的 affinity 字段下的 nodeAffinity 字段进行指定。
下面的配置清单中定义的Pod对象,使用节点硬亲和性和规则定义将当前Pod调度到标签为network=enet或network=wnet的节点上
1 | apiVersion: v1 |
还可以在硬亲和的同时添加软亲和条件(在满足硬亲和条件中的主机优秀选择满足软亲和条件的节点)
下面的配置清单中定义的Pod对象,节点硬亲和节点标签network=enet或network=wnet后优先选择节点标签为disktype=ssd的节点调度
1 | apiVersion: v1 |
12.4.2 节点软亲和性
1 | apiVersion: apps/v1 |
上面的实验结果显示,当2个标签没有都存在一个node节点上时,Pod对象会被分散在集群中的三个节点上进行创建并运行,之所以如此,是因为使用了 节点软亲和性的预选方式,所有的节点都能够通过MatchNodeSelector预选策略的筛选。当我们将2个标签都集合在node01上时,所有Pod对象都会运行在node01之上。
注意事项:
你可以在上面的例子中看到
In操作符的使用。新的节点亲和语法支持下面的操作符:In,NotIn,Exists,DoesNotExist,Gt,Lt。你可以使用NotIn和DoesNotExist来实现节点反亲和行为,或者使用节点污点将 pod 从特定节点中驱逐。如果你同时指定了
nodeSelector和nodeAffinity,两者必须都要满足,才能将 pod 调度到候选节点上。如果你指定了多个与
nodeAffinity类型关联的nodeSelectorTerms,则如果其中一个nodeSelectorTerms满足的话,pod将可以调度到节点上。如果你指定了多个与
nodeSelectorTerms关联的matchExpressions,则只有当所有matchExpressions满足的话,pod 才会可以调度到节点上。如果你修改或删除了 pod 所调度到的节点的标签,pod 不会被删除。换句话说,亲和选择只在 pod 调度期间有效。
preferredDuringSchedulingIgnoredDuringExecution中的weight字段值的范围是 1-100。对于每个符合所有调度要求(资源请求,RequiredDuringScheduling 亲和表达式等)的节点,调度器将遍历该字段的元素来计算总和,并且如果节点匹配对应的MatchExpressions,则添加“权重”到总和。然后将这个评分与该节点的其他优先级函数的评分进行组合。总分最高的节点是最优选的。
12.5 Pod资源亲和与反亲和调度
在出于高效通信的需求,有时需要将一些Pod调度到相近甚至是同一区域位置(比如同一节点、机房、区域)等等,比如业务的前端Pod和后端Pod,此时这些Pod对象之间的关系可以叫做亲和性。
同时出于安全性的考虑,也会把一组Pod分别调度到不同节点上,Pod之间进行隔离,此时这些Pod对象之间的关系叫做反亲和性(anti-affinity)。
调度器把第一个Pod放到任意位置,然后和该Pod有亲和或反亲和关系的Pod根据该动态完成位置编排,这就是Pod亲和性和反亲和性调度的作用。Pod的亲和性定义也存在硬亲和性和软亲和性的区别,其约束的意义和节点亲和性类似。
Pod的亲和性调度要求各相关的Pod对象运行在同一位置,而反亲和性则要求它们不能运行在同一位置。这里的位置实际上取决于节点的位置拓扑,拓扑的方式不同,Pod是否在同一位置的判定结果也会有所不同,使用 topologyKey 来表示它,topologyKey 是节点标签的键以便系统用来表示这样的拓扑域。
如果基于各个节点的kubernetes.io/hostname标签作为评判标准,那么会根据节点的hostname去判定是否在同一位置区域
12.5.1 Pod硬亲和
Pod强制约束的亲和性调度也是使用requiredDuringSchedulingIgnoredDuringExecution进行定义的。Pod 间亲和通过 PodSpec 中 affinity 字段下的 podAffinity 字段进行指定。而 pod 间反亲和通过 PodSpec 中 affinity 字段下的 podAntiAffinity 字段进行指定。
Pod亲和性是用来描述一个Pod对象和现有的Pod对象运行的位置存在某种依赖关系,所以如果要测试Pod亲和性约束,需要存在一个被依赖的Pod对象,下面创建一个带有app=tomcat的Deployment资源部署一个Pod对象
1 | [root@k8s-master ~]# kubectl run tomcat -l app=tomcat --image=tomcat:alpine |
从上面我们可以看到新创建的tomcatpod对象被调度在k8s-node01上,再写一个配置清单定义一个Pod对象,通过labelSelector定义的标签选择器挑选对应的Pod对象
1 | [root@k8s-master ~]# vim required-podAffinity-pod1.yaml |
kubernetes.io/hostname标签是Kubernetes集群节点的内建标签,它的值为当前节点的主机名,对于各个节点来说都是不同的。所以新建的Pod对象要被部署到和tomcat所在的同一个节点上。
1 | [root@k8s-master ~]# kubectl apply -f required-podAffinity-pod1.yaml |
基于单一节点的Pod亲和性相对来说使用的情况会比较少,通常使用的是基于同一地区、区域、机架等拓扑位置约束。比如部署应用程序(myapp)和数据库(db)服务相关的Pod时,这两种Pod应该部署在同一区域上,可以加速通信的速度。
12.5.2 Pod软亲和
同理,有硬亲和度即有软亲和度,Pod也支持使用preferredDuringSchedulingIgnoredDuringExecuttion属性进行定义Pod的软亲和性,调度器会尽力满足亲和约束的调度,在满足不了约束条件时,也允许将该Pod调度到其他节点上运行。比如下面这一配置清单:
1 | apiVersion: apps/v1 |
上述的清单配置当中,pod的软亲和调度需要将Pod调度到标签为app=cache并在区域zone当中,或者调度到app=db标签节点上的,但是我们的节点上并没有类似的标签,所以调度器会根据软亲和调度进行随机调度到k8s-node01节点之上。如下:
1 | [root@k8s-master ~]# kubectl apply -f deploy-with-preferred-podAffinity.yaml |
12.5.3 Pod的反亲和
podAffinity定义了Pod对象的亲和约束,而Pod对象的反亲和调度则是用podAntiAffinty属性进行定义,下面的配置清单中定义了由同一Deployment创建但是彼此基于节点名称互斥的Pod对象:
1 | [root@k8s-master schudler]# cat podAntiAffinity-deploy.yaml |
由于在配置清单中定义了强制性反亲和性(以节点名称为判断基础),所以创建的3个Pod副本必须 运行在不同的节点当中呢,但是集群中只存在3个节点(master节点存在污点,未配置污点容忍所以无法调度pod到此节点),因此,肯定会有一个Pod对象处于Pending的状态。
12.5.4 Pod亲和度注意事项
Pod 亲和与反亲和的合法操作符有 In,NotIn,Exists,DoesNotExist。
原则上,topologyKey 可以是任何合法的标签键。然而,出于性能和安全原因,topologyKey 受到一些限制:
- 对于亲和与
requiredDuringSchedulingIgnoredDuringExecution要求的 pod 反亲和,topologyKey不允许为空。 - 对于
requiredDuringSchedulingIgnoredDuringExecution要求的 pod 反亲和,准入控制器LimitPodHardAntiAffinityTopology被引入来限制topologyKey不为kubernetes.io/hostname。如果你想使它可用于自定义拓扑结构,你必须修改准入控制器或者禁用它。 - 对于
preferredDuringSchedulingIgnoredDuringExecution要求的 pod 反亲和,空的topologyKey被解释为“所有拓扑结构”(这里的“所有拓扑结构”限制为kubernetes.io/hostname,failure-domain.beta.kubernetes.io/zone和failure-domain.beta.kubernetes.io/region的组合)。 - 除上述情况外,
topologyKey可以是任何合法的标签键。
除了 labelSelector 和 topologyKey,你也可以指定表示命名空间的 namespaces 队列,labelSelector 也应该匹配它(这个与 labelSelector 和 topologyKey 的定义位于相同的级别)。如果忽略或者为空,则默认为 pod 亲和/反亲和的定义所在的命名空间。
所有与 requiredDuringSchedulingIgnoredDuringExecution 亲和与反亲和关联的 matchExpressions 必须满足,才能将 pod 调度到节点上。
12.6 污点和污点容忍度
节点亲和性(详见这里),是 pod 的一种属性(偏好或硬性要求),它使 pod 被吸引到一类特定的节点。Taint 则相反,它使 节点 能够 排斥 一类特定的 pod。
Taint 和 toleration 相互配合,可以用来避免 pod 被分配到不合适的节点上。每个节点上都可以应用一个或多个 taint ,这表示对于那些不能容忍这些 taint 的 pod,是不会被该节点接受的。如果将 toleration 应用于 pod 上,则表示这些 pod 可以(但不要求)被调度到具有匹配 taint 的节点上
前面的节点选择器和节点亲和性的调度方式都是通过在Pod对象上添加标签选择器来完成对特定类型节点标签的匹配,实现的是Pod选择节点的方式。而污点和容忍度则是通过对节点添加污点信息来控制Pod对象的调度结果,让节点拥有了控制哪种Pod对象可以调度到该节点上的 一种方式。
Kubernetes使用PodToleratesNodeTaints预选策略和TaintTolerationPriority优选函数来完成这种调度方式
12.6.1 定义污点和容忍度
污点的定义是在节点的nodeSpec,而容忍度的定义是在Pod中的podSpec,都属于键值型数据,两种方式都支持一个effect标记,语法格式为key=value: effect,其中key和value的用户和格式和资源注解类似,而effect是用来定义对Pod对象的排斥等级,主要包含以下3种类型:
- NoSchedule:不能容忍此污点的新Pod对象不能调度到该节点上,属于强制约束,节点现存的Pod对象不受影响。
- PreferNoSchedule:NoSchedule属于柔性约束,即不能容忍此污点的Pod对象尽量不要调度到该节点,不过无其他节点可以调度时也可以允许接受调度。
- NoExecute:不能容忍该污点的新Pod对象不能调度该节点上,强制约束,节点现存的Pod对象因为节点污点变动或Pod容忍度的变动导致无法匹配规则,Pod对象就会被从该节点上驱逐。
在Pod对象上定义容忍度时,其支持2中操作符:Equal和Exists
- Equal:等值比较,表示容忍度和污点必须在key、value、effect三者之上完全匹配。
- Exists:存在性判断,表示二者的key和effect必须完全匹配,而容忍度中的value字段使用空值。
在使用kubeadm部署的集群中,master节点上将会自动添加污点信息,阻止不能容忍该污点的Pod对象调度到该节点上,如下:
1 | [root@k8s-master ~]# kubectl describe node k8s-master |
而一系统级别的应用在创建时,就会添加相应的容忍度来确保被创建时可以调度到master节点上,如flannel插件:
1 | [root@k8s-master ~]# kubectl describe pods kube-flannel-ds-amd64-2p8wm -n kube-system |
12.6.2 管理节点的污点
使用命令行给节点添加污点
1 | #语法:kubectl taint nodes <nodename> <key>=<value>:<effect>...... |
此时,node01节点上已经存在的Pod对象不受影响,仅对新建Pod对象有影响,需要注意的是,如果是同一个键值数据,但是最后的标识不同,也是属于不同的污点信息,比如再给node01上添加一个污点的标识为:PreferNoSchedule
1 | [root@k8s-master ~]# kubectl taint nodes k8s-node01 node-type=production:PreferNoSchedule |
删除污点
1 | 语法:kubectl taint nodes <node-name> <key>[: <effect>]- |
12.6.3 Pod对象污点容忍度
Pod容忍度定义
Pod对象的容忍度可以通过spec.tolerations字段进行添加,同一的也有两种操作符:Equal和Exists方式。
Equal等值方式如下:
1 | tolerations: |
Exists方式如下:
1 | tolerations: |
一个 toleration 和一个 taint 相“匹配”是指它们有一样的 key 和 effect ,并且:
- 如果
operator是Exists(此时 toleration 不能指定value),或者 - 如果
operator是Equal,则它们的value应该相等
存在两种特殊情况:
如果一个 toleration 的
key为空且 operator 为Exists,表示这个 toleration 与任意的 key 、 value 和 effect 都匹配,即这个 toleration 能容忍任意 taint。1
2tolerations:
- operator: "Exists"如果一个 toleration 的
effect为空,则key值与之相同的相匹配 taint 的effect可以是任意值。1
2
3tolerations:
- key: "key"
operator: "Exists"
上述例子使用到的 effect 的一个值 NoSchedule,您也可以使用另外一个值 PreferNoSchedule。这是“优化”或“软”版本的 NoSchedule ——系统会 尽量 避免将 pod 调度到存在其不能容忍 taint 的节点上,但这不是强制的。effect 的值还可以设置为 NoExecute ,下文会详细描述这个值。
您可以给一个节点添加多个 taint ,也可以给一个 pod 添加多个 toleration。Kubernetes 处理多个 taint 和 toleration 的过程就像一个过滤器:从一个节点的所有 taint 开始遍历,过滤掉那些 pod 中存在与之相匹配的 toleration 的 taint。余下未被过滤的 taint 的 effect 值决定了 pod 是否会被分配到该节点,特别是以下情况:
- 如果未被过滤的 taint 中存在一个以上 effect 值为
NoSchedule的 taint,则 Kubernetes 不会将 pod 分配到该节点。 - 如果未被过滤的 taint 中不存在 effect 值为
NoSchedule的 taint,但是存在 effect 值为PreferNoSchedule的 taint,则 Kubernetes 会 尝试 将 pod 分配到该节点。 - 如果未被过滤的 taint 中存在一个以上 effect 值为
NoExecute的 taint,则 Kubernetes 不会将 pod 分配到该节点(如果 pod 还未在节点上运行),或者将 pod 从该节点驱逐(如果 pod 已经在节点上运行)。
例如,假设您给一个节点添加了如下的 taint
1 | kubectl taint nodes node1 key1=value1:NoSchedule |
然后存在一个 pod,它有两个 toleration
1 | tolerations: |
在这个例子中,上述 pod 不会被分配到上述节点,因为其没有 toleration 和第三个 taint 相匹配。但是如果在给节点添加 上述 taint 之前,该 pod 已经在上述节点运行,那么它还可以继续运行在该节点上,因为第三个 taint 是三个 taint 中唯一不能被这个 pod 容忍的。
通常情况下,如果给一个节点添加了一个 effect 值为 NoExecute 的 taint,则任何不能忍受这个 taint 的 pod 都会马上被驱逐,任何可以忍受这个 taint 的 pod 都不会被驱逐。但是,如果 pod 存在一个 effect 值为 NoExecute 的 toleration 指定了可选属性 tolerationSeconds 的值,则表示在给节点添加了上述 taint 之后,pod 还能继续在节点上运行的时间。例如,
1 | tolerations: |
这表示如果这个 pod 正在运行,然后一个匹配的 taint 被添加到其所在的节点,那么 pod 还将继续在节点上运行 3600 秒,然后被驱逐。如果在此之前上述 taint 被删除了,则 pod 不会被驱逐。
基于 taint 污点的驱逐
前文我们提到过 taint 的 effect 值 NoExecute ,它会影响已经在节点上运行的 pod
- 如果 pod 不能忍受effect 值为
NoExecute的 taint,那么 pod 将马上被驱逐 - 如果 pod 能够忍受effect 值为
NoExecute的 taint,但是在 toleration 定义中没有指定tolerationSeconds,则 pod 还会一直在这个节点上运行。 - 如果 pod 能够忍受effect 值为
NoExecute的 taint,而且指定了tolerationSeconds,则 pod 还能在这个节点上继续运行这个指定的时间长度。
此外,Kubernetes 1.6 已经支持(alpha阶段)节点问题的表示。换句话说,当某种条件为真时,node controller会自动给节点添加一个 taint。当前内置的 taint 包括:
node.kubernetes.io/not-ready:节点未准备好。这相当于节点状态Ready的值为 “False“。node.kubernetes.io/unreachable:node controller 访问不到节点. 这相当于节点状态Ready的值为 “Unknown“。node.kubernetes.io/out-of-disk:节点磁盘耗尽。node.kubernetes.io/memory-pressure:节点存在内存压力。node.kubernetes.io/disk-pressure:节点存在磁盘压力。node.kubernetes.io/network-unavailable:节点网络不可用。node.kubernetes.io/unschedulable: 节点不可调度。node.cloudprovider.kubernetes.io/uninitialized:如果 kubelet 启动时指定了一个 “外部” cloud provider,它将给当前节点添加一个 taint 将其标志为不可用。在 cloud-controller-manager 的一个 controller 初始化这个节点后,kubelet 将删除这个 taint。
在版本1.13中,TaintBasedEvictions 功能已升级为Beta,并且默认启用,因此污点会自动给节点添加这类 taint,上述基于节点状态 Ready 对 pod 进行驱逐的逻辑会被禁用。
注意:
为了保证由于节点问题引起的 pod 驱逐rate limiting行为正常,系统实际上会以 rate-limited 的方式添加 taint。在像 master 和 node 通讯中断等场景下,这避免了 pod 被大量驱逐。
使用这个 beta 功能特性,结合 tolerationSeconds ,pod 就可以指定当节点出现一个或全部上述问题时还将在这个节点上运行多长的时间。
比如,一个使用了很多本地状态的应用程序在网络断开时,仍然希望停留在当前节点上运行一段较长的时间,愿意等待网络恢复以避免被驱逐。在这种情况下,pod 的 toleration 可能是下面这样的:
1 | tolerations: |
注意,Kubernetes 会自动给 pod 添加一个 key 为 node.kubernetes.io/not-ready 的 toleration 并配置 tolerationSeconds=300,除非用户提供的 pod 配置中已经已存在了 key 为 node.kubernetes.io/not-ready 的 toleration。同样,Kubernetes 会给 pod 添加一个 key 为 node.kubernetes.io/unreachable 的 toleration 并配置 tolerationSeconds=300,除非用户提供的 pod 配置中已经已存在了 key 为 node.kubernetes.io/unreachable 的 toleration。
这种自动添加 toleration 机制保证了在其中一种问题被检测到时 pod 默认能够继续停留在当前节点运行 5 分钟。这两个默认 toleration 是由 DefaultTolerationSeconds admission controller添加的。
DaemonSet 中的 pod 被创建时,针对以下 taint 自动添加的 NoExecute 的 toleration 将不会指定 tolerationSeconds:
node.kubernetes.io/unreachablenode.kubernetes.io/not-ready
这保证了出现上述问题时 DaemonSet 中的 pod 永远不会被驱逐,这和 TaintBasedEvictions 这个特性被禁用后的行为是一样的。